Domain 24dev.de kaufen?
Wir ziehen mit dem Projekt
24dev.de um.
Sind Sie am Kauf der Domain
24dev.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain 24dev.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **

Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Hahn, Martin: WebdesignWebdesign , Das neue Handbuch zur Webgestaltung. Alles, was Webdesigner wissen müssen. Mit vielen inspirierenden Beispielen (neue Auflage 2024) , Sport-Stoßdämpfer > Sportfederung , Auflage: 4. Auflage, Erscheinungsjahr: 20240305, Produktform: Leinen, Titel der Reihe: Rheinwerk Design##, Autoren: Hahn, Martin, Edition: REV, Auflage: 24004, Auflage/Ausgabe: 4. Auflage, Seitenzahl/Blattzahl: 647, Themenüberschrift: COMPUTERS / Web / Design, Keyword: Barrierefreiheit; CSS-3; Content; Designer Konzeption; HTML-5; Hand-Buch Bücher Anleitung lernen Tipps; Inklusion; Usability Responsive Layouts; User ExperienceUX; Web-Design; Web-Farben; Web-Schriften; Web-Standards; Web-Typografie; Webseiten gestalten Websites; Workshops, Fachschema: Internet / Programmierung~Internet / Publishing, Web-Site-Design~Social Media~Social Network~Soziales Netzwerk~Internet~Surfen (Internet), Fachkategorie: Web-Grafik und -Design~Webprogrammierung~Internet, allgemein~Computernetzwerke und maschinelle Kommunikation, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 243, Breite: 185, Höhe: 38, Gewicht: 1720, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Einführung in die Internet-Programmierung. WebDesign, HTML, CSS, JavaScript, SEO, Taschenbuch von Eugen Grinschuk,Daniel Falkner, GRIN,Einführung In Die Internet-programmierung. Webdesign, Html, Css, Javascript, Seo, Taschenbuch Von Eugen Grinschuk,daniel Falkner, Grin, 978-3-668-11389-3, Seitenanzahl: 2817,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Software Development, Design, and Coding, Fachbücher von John F. DooleyDas Fachbuch "Software Development, Design, and Coding" bietet eine umfassende Einführung in die Prinzipien des Software-Designs und deren Umsetzung in qualitativ hochwertigen Code. Es behandelt die Grundlagen der Softwaretechnik, einschliesslich der Anwendung von Ingenieurprinzipien auf die Softwareentwicklung. Leser erfahren, wie man ein Softwareentwicklungsprojekt leitet, die verschiedenen Phasen eines Projekts analysiert und Programme entwirft sowie implementiert, die spezifische Probleme lösen. Die dritte Auflage wurde überarbeitet, um signifikante Veränderungen in der Softwareentwicklungslandschaft widerzuspiegeln, einschliesslich aktualisierter Design- und Codierungsbeispiele. Ein besonderes Augenmerk liegt auf agilen Methoden wie Scrum, Lean Software Development und Kanban. Darüber hinaus wird die Bedeutung der zwischenmenschlichen Aspekte in der Softwareentwicklung hervorgehoben. Dieses Buch richtet sich sowohl an Einsteiger als auch an erfahrene Programmierer, die ihre Fähigkeiten weiterentwickeln möchten.64,19 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Hahn, Martin: WebdesignWebdesign , Das neue Handbuch zur Webgestaltung. Alles, was Webdesigner wissen müssen. Mit vielen inspirierenden Beispielen (neue Auflage 2024) , Sport-Stoßdämpfer > Sportfederung , Auflage: 4. Auflage, Erscheinungsjahr: 20240305, Produktform: Leinen, Titel der Reihe: Rheinwerk Design##, Autoren: Hahn, Martin, Edition: REV, Auflage: 24004, Auflage/Ausgabe: 4. Auflage, Seitenzahl/Blattzahl: 647, Themenüberschrift: COMPUTERS / Web / Design, Keyword: Barrierefreiheit; CSS-3; Content; Designer Konzeption; HTML-5; Hand-Buch Bücher Anleitung lernen Tipps; Inklusion; Usability Responsive Layouts; User ExperienceUX; Web-Design; Web-Farben; Web-Schriften; Web-Standards; Web-Typografie; Webseiten gestalten Websites; Workshops, Fachschema: Internet / Programmierung~Internet / Publishing, Web-Site-Design~Social Media~Social Network~Soziales Netzwerk~Internet~Surfen (Internet), Fachkategorie: Web-Grafik und -Design~Webprogrammierung~Internet, allgemein~Computernetzwerke und maschinelle Kommunikation, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 243, Breite: 185, Höhe: 38, Gewicht: 1720, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
Einführung in die Internet-Programmierung. WebDesign, HTML, CSS, JavaScript, SEO, Taschenbuch von Eugen Grinschuk,Daniel Falkner, GRIN,Einführung In Die Internet-programmierung. Webdesign, Html, Css, Javascript, Seo, Taschenbuch Von Eugen Grinschuk,daniel Falkner, Grin, 978-3-668-11389-3, Seitenanzahl: 2817,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
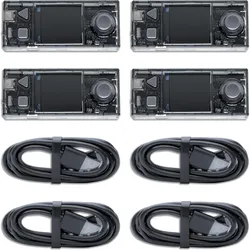
Makeblock CyberPi Classroom Coding Pack (4 in 1) (Software), Robotik ZubehörCyberPi: Netzwerkfähiger Mikrocontroller für die Informatik und AI-Ausbildung. CyberPi ist ein Single-Board-Computer, ausgestattet mit fortschrittlicher Elektronik. In Kombination mit dem beeindruckenden mBlock-Codierungseditor unterstützt er die Entwicklung von Programmierfähigkeiten von Scratch bis Python. Die Integration von Hardware und Software macht ihn zu einem leistungsstarken Werkzeug, um Data Science, künstliche Intelligenz, Netzwerke und das Internet der Dinge in einer Lernumgebung zu entdecken. Highlights: - Von blockbasierter Programmierung bis Python - Grundlagen der Datenwissenschaft, Netzwerke, IoT und AI erforschen - Mehr Möglichkeiten durch die elektronischen Module von mBuild - Mit mBlock 5 können Sie CyberPi steuern und Ihre Programmierfähigkeiten entwickeln, von blockbasierter Programmierung bis hin zu Python, alles innerhalb derselben Plattform. - Mit dem integrierten WIFI-Modul können Sie lokale Netzwerke zwischen mehreren CyberPi erstellen, eine Verbindung zum Internet herstellen und das Internet der Dinge erkunden. - Erfahren Sie mehr über künstliche Intelligenz, die Hardware und Software kombiniert, um die Erkennung von Bild, Sprache, Text und mehr anzuwenden. - Entwickeln Sie Spiele und viel mehr - mit den zahlreich integrierten Sensoren. - Der praktische Teil ist am schönsten - insbesondere Experimente und das Programmieren von eigenen interaktiven Videospielen. - Unterrichten Sie mit den geführten Aktivitäten und Unterrichtsplänen von Makeblock Education und Partnern, die für verschiedene Bildungsstufen geeignet sind. Das CyberPi Classroom Coding Kit enthält 4 CyberPi, wodurch es sich ideal für die Arbeit mit einer Gruppe von Schülern eignet. Diese können dank der 4 USB Typ C-Kabel, die im Kit enthalten sind, an Computer angeschlossen werden, wodurch die Schülerinnen und Schüler direkt an ihren Projekten arbeiten können.189,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.